Ratgeber zur KI-Erkennung
Ist ZeroGPT zuverlässig?
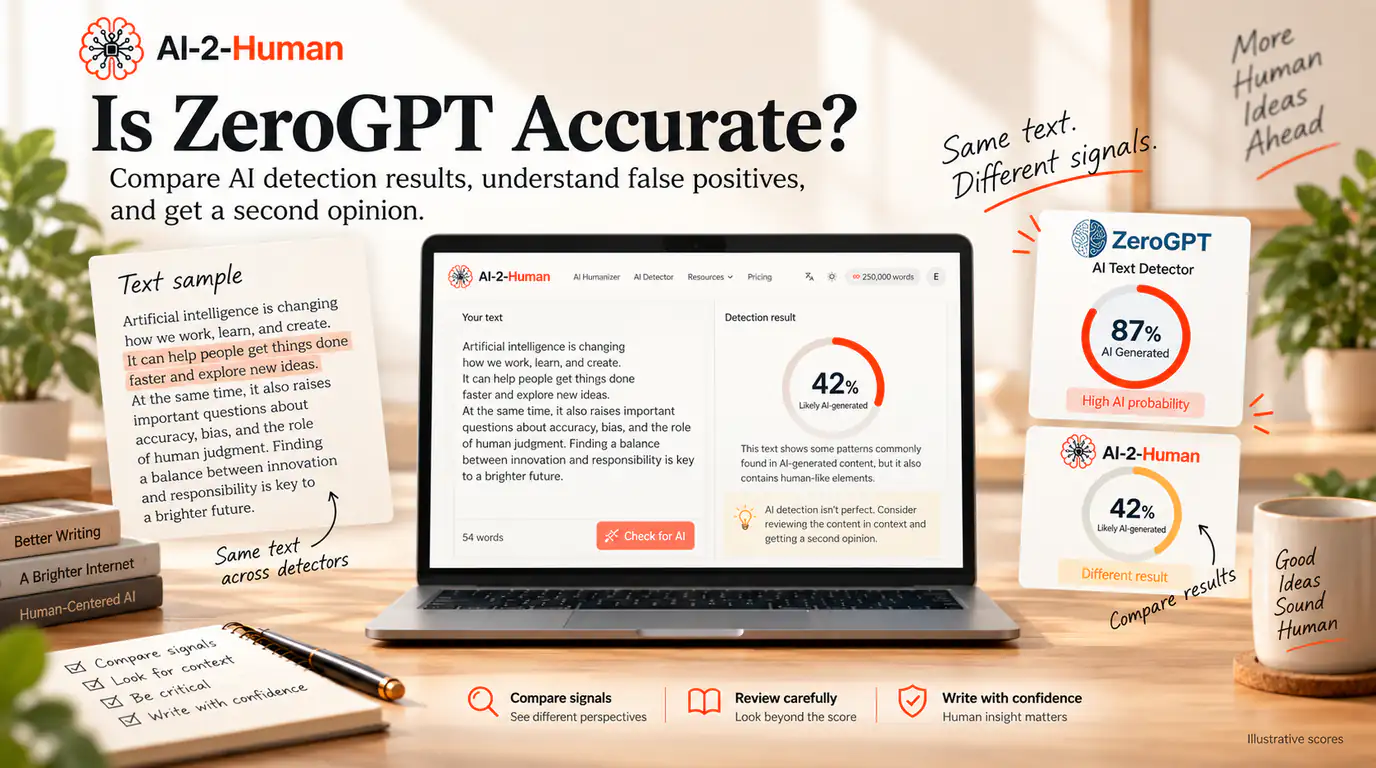
ZeroGPT kann KI-generierte Texte in vielen Fällen von menschlicher Schreibe trennen, ist aber nicht vollkommen genau. Unabhängige Studien, die es mit akademischen und wissenschaftlichen Datensätzen getestet haben, melden starke Ergebnisse bei einem und deutlich schwächere bei einem anderen Datensatz, und sowohl falsch-positive als auch falsch-negative Ergebnisse kommen vor. Ein ZeroGPT-Wert ist deshalb am nützlichsten als Signal zum Nachprüfen und nicht als Beweis dafür, wie eine Passage entstanden ist. Wer eine zweite Meinung möchte, kann denselben Text durch den AI-2-Human Detector laufen lassen und vergleichen, was beide Werkzeuge hervorheben.
Was ist ZeroGPT?
ZeroGPT (zerogpt.com) ist ein KI-Textdetektor. Sie fügen einen Text ein oder laden eine Datei hoch, und er liefert einen KI-Wahrscheinlichkeitswert für das Dokument zusammen mit den Passagen, die er für KI-ähnlich hält. Der kostenlose Detektor nimmt bis zu 15.000 Zeichen pro Prüfung an, und die Oberfläche kann einen PDF-Bericht zum Ergebnis erzeugen. Sein breiteres Werkzeugpaket umfasst eine Plagiatsprüfung, einen Paraphrasierer und einen Humanizer.
Die eigene Dokumentation beschreibt den Detektor als ein System, das sprachliche und statistische Signale aus menschlichem und KI-Text auswertet, darunter Token-Muster, Burstiness, Entropie und Merkmale eines Ensemble-Klassifikators. Was sie nicht veröffentlicht, sind die trainierten Gewichte und die Entscheidungsschwellen, weshalb die Zahl als Schätzung eines Modells zu lesen ist und nicht als Messung der Urheberschaft.
Wie genau ist ZeroGPT?
Es gibt keinen einzelnen ZeroGPT-Genauigkeitswert, der für jede Art von Text gilt. Veröffentlichte Schätzungen reichen von stark bis mittelmäßig, und beide Enden stammen aus legitimen Tests, weil der Wert eines Detektors vom Datensatz, vom Genre, vom erzeugenden Modell, von der Länge der Stichprobe, davon, wie stark sie bearbeitet wurde, von der gewählten Schwelle und davon abhängt, wie die Studie KI-generiertes Schreiben definiert.
Die FAQ von ZeroGPT nennen das Ziel, bei internen Auswertungen über 98 % Genauigkeit zu erreichen, und die Startseite bewirbt 98,4 % Erkennungsgenauigkeit bei einer Falsch-Positiv-Rate unter 1 %. Diese Zahlen stammen aus den eigenen Tests des Unternehmens. Unabhängige Teams, die dasselbe Werkzeug auf ihren eigenen Datensätzen erneut geprüft haben, haben ganz andere Zahlen gemeldet, und diese Messungen sind es, die man lesen sollte, bevor ein Wert als entscheidend gilt.
Die ehrliche Antwort ist also ein Bereich mit Bedingungen: ZeroGPT trennte in einer Studie mit 1.000 Texten menschliches von ChatGPT-erzeugtem akademischem Schreiben gut und schnitt auf einem anderen Datensatz mit wissenschaftlichen Zusammenfassungen deutlich schlechter ab. Der nächste Abschnitt zeigt beide Messungen nebeneinander.
Was unabhängige Forschung über ZeroGPT sagt
Die erste Studie, 2025 in Acta Neurochirurgica veröffentlicht, stellte 1.000 Texte zusammen: 250 von Menschen geschriebene Zusammenfassungen und Einleitungen aus vier hochrangigen neurochirurgischen Fachzeitschriften, erschienen vor ChatGPT, plus 750 Versionen desselben Materials, erzeugt von ChatGPT 3.5, GPT-4 und GPT-4o. Mit ZeroGPT lag der durchschnittliche KI-Wahrscheinlichkeitswert bei 27,55 % für die menschlichen Texte, bei 81,48 % für GPT-3.5, bei 87,39 % für GPT-4 und bei 94,35 % für GPT-4o: eine deutliche Trennung zwischen menschlicher und generierter Gruppe. Mit der von den Forschenden gewählten Grenze erreichte ZeroGPT 94,4 % Sensitivität und 93,2 % Spezifität, erkannte also den größten Teil des KI-Textes und erkannte den größten Teil des menschlichen Textes korrekt als solchen.
Acta Neurochirurgica: Genauigkeit und Grenzen von KI-Erkennungstools
Dieselbe Arbeit maß GPTZero auf diesem Datensatz bei 100 % Sensitivität und 99,6 % Spezifität. Das lohnt sich aus zwei Gründen zu wissen: Es zeigt, dass eine einzelne Studie Werkzeuge für ihre eigenen Texte einordnet und nicht allgemein, und es zeigt, dass auch ein Detektor nahe der Spitze eines Benchmarks im weiteren Bild, das die Autorinnen und Autoren beschreiben, noch Fehler hatte.
Die zweite Studie, 2025 in PeerJ Computer Science veröffentlicht, verglich von Menschen geschriebene wissenschaftliche Zusammenfassungen mit Zusammenfassungen von ChatGPT o1 und Gemini 2.0 Pro Experimental und betrachtete dann ein zweites Szenario, in dem diese Modelle den Originaltext zur besseren Lesbarkeit überarbeitet hatten. Auf dem ersten Datensatz erreichte ZeroGPT 64,35 % Gesamtgenauigkeit, mit einer Falsch-Positiv-Rate von 16,67 % und einer Falsch-Negativ-Rate von 45,14 %. Thema der Arbeit ist der Kompromiss zwischen Genauigkeit und Verzerrung: Sie berichtet, dass die Fehler nicht gleichmäßig verteilt waren, sondern überproportional auf nicht muttersprachlich englisch schreibende Personen und auf bestimmte Disziplinen entfielen.
PeerJ Computer Science: Kompromisse zwischen Genauigkeit und Verzerrung bei der KI-Text-Erkennung
Eine dritte Studie, 2025 in Advances in Simulation veröffentlicht, verglich ZeroGPT, PhraslyAI und den KI-Detektor von Grammarly über fünf Bedingungen der KI-Nutzung, von unveränderten menschlichen Einleitungen bis zu stark KI-unterstützten, anhand von 30 vor 2022 erschienenen Artikeln. Die Werte bewegten sich mit der Bedingung, und die Werkzeuge stimmten beim selben Material nicht überein. Diese Uneinigkeit ist die praktische Lehre dieses Abschnitts: Die Zahl ist eine Eigenschaft eines Textes, eines Modells und einer Schwelle, nicht der Urheberschaft.
Advances in Simulation: verschiedene Formen KI-generierter Inhalte erkennen
Keine dieser Arbeiten fand einen Detektor, der immer richtig lag, auch nicht die Werkzeuge mit den besten Ergebnissen auf ihrem eigenen Datensatz.
Kann ZeroGPT menschliches Schreiben als KI markieren?
Ja. Ein falsch-positives Ergebnis ist menschliches Schreiben, das als KI-generiert eingeordnet wird, und unabhängige Forschung hat das bei ZeroGPT dokumentiert. In einer kleinen explorativen Studie im ASEAN Journal of Open and Distance Learning wurden zehn authentische Essays philippinischer Studierender an ZeroGPT und an einen zweiten Detektor geschickt. Alle zehn stammten von Studierenden, und die Werkzeuge teilten das Set in zwei Hälften: Fünf Essays wurden als KI-generiert etikettiert und fünf als menschlich. Die Autorinnen und Autoren beschreiben das Ergebnis als Risiko der Fehlklassifizierung und plädieren für menschliches Urteil statt Detektor-Ausgabe als Beleg.
ASEAN Journal of Open and Distance Learning: falsch-positive Ergebnisse bei der KI-Schreib-Erkennung
Zehn Essays sind eine kleine Stichprobe, lesen Sie diese Studie also als Veranschaulichung des Risikos und nicht als Messung der Fehlerrate von ZeroGPT. Der PeerJ-Datensatz ist die quantitativere Warnung: 16,67 % falsch-positive Ergebnisse bei wissenschaftlichen Zusammenfassungen, mit einer Genauigkeit, die je nach Autorenkategorie schwankte. Auch die FAQ von ZeroGPT räumt den Mechanismus ein: Sie erklärt, dass sehr poliertes, schablonenhaftes oder entropiearmes Schreiben wie KI wirken kann, und empfiehlt konkrete Details, Quellen und einen abwechslungsreichen Satzrhythmus, um das Risiko zu senken. Formales, schablonenhaftes oder zweitsprachliches Schreiben ist genau der Bereich, in dem ein Detektor am ehesten falschliegt.
Kann ZeroGPT KI-generierte Texte übersehen?
Ja, in die andere Richtung. Ein falsch-negatives Ergebnis ist KI-generierter Text, der als menschlich eingeordnet wird, und dieselbe PeerJ-Studie maß auf ihrem Datensatz eine Falsch-Negativ-Rate von 45,14 %: Fast die Hälfte der generierten Zusammenfassungen, die der Test erwartungsgemäß markieren sollte, kam als menschlich zurück. Im Datensatz von Acta Neurochirurgica war die Trennung deutlich besser, mit menschlichen Texten bei durchschnittlich 27,55 % und GPT-3.5-Texten bei durchschnittlich 81,48 %, aber Durchschnitte verbergen Streuung. Einzelne Stichproben überlappen sich zwischen beiden Gruppen, und genau deshalb braucht ein Klassifikator eine Grenze und muss diese Grenze die eine Fehlerart gegen die andere abwägen.
KI-generiertes Schreiben ist auch keine feste Kategorie. Eine rohe Modellausgabe, eine leicht paraphrasierte Fassung und ein Text, der erzeugt und danach von Hand umgeschrieben wurde, sind für einen Klassifikator verschiedene Objekte, und die Studie in Advances in Simulation zeigte Werte, die sich mit dem Grad der KI-Beteiligung bewegten. Ein niedriger Wert belegt deshalb nicht, dass ein Text menschlich ist, so wie ein hoher Wert nicht belegt, dass er von einer Maschine stammt.
Warum ZeroGPT-Ergebnisse schwanken können
Wenn derselbe Abschnitt in zwei Tests sehr unterschiedlich bewertet wird, ist das zu erwarten und keine Fehlfunktion. Die folgenden Variablen erklären den größten Teil der Bewegung, und sie sind zugleich die Gründe, warum ein Wert sich schlecht von einem Kontext in einen anderen übertragen lässt.
- Textlänge: ZeroGPT empfiehlt mindestens 150 bis 200 Wörter für eine stabile Lesart und erklärt, 500 bis 1.000 oder mehr verbesserten die Verlässlichkeit. Ein kurzer Absatz trägt in keine Richtung viel Evidenz.
- Genre: Akademische Prosa, Werbetexte, persönliche Essays und technische Dokumentation haben unterschiedliche Rhythmen, und ein auf gemischten Datensätzen trainiertes Modell behandelt sie ungleich.
- Erzeugendes Modell: GPT-3.5, GPT-4 und GPT-4o schreiben unterschiedlich, und die Studie in Acta Neurochirurgica maß über diese Versionen hinweg steigende KI-Wahrscheinlichkeitswerte.
- Bearbeitung: Ein erzeugter und danach stark umgeschriebener Text liegt zwischen den beiden Kategorien, und dort sind Detektoren am instabilsten.
- Menschlicher Stil: Formales, schablonenhaftes oder zweitsprachliches Schreiben kann statistischen Mustern entsprechen, die mit Maschintext verbunden werden, und die PeerJ-Studie fand Genauigkeitsunterschiede je nach Autorenkategorie.
- Schwelle: Ein Klassifikator muss eine Entscheidungsgrenze wählen, und deren Verschiebung tauscht falsch-positive gegen falsch-negative Ergebnisse. ZeroGPT veröffentlicht seine eigene Grenze nicht.
- Produktversion: Erkennungssysteme werden neu trainiert und aktualisiert, ein Ergebnis vom letzten Jahr lässt sich also heute möglicherweise nicht reproduzieren.
Diese Variablen sind das Argument dafür, jeden einzelnen Wert als vorläufig zu behandeln und ein wichtiges Ergebnis gegen eine zweite Lesart abzugleichen statt gegen das eigene Bauchgefühl zum Werkzeug.
Wie Sie einen ZeroGPT-Wert deuten
Ein ZeroGPT-Prozentwert ist eine Schätzung eines Modells. Er belegt keine Urheberschaft, kein Plagiat, kein Fehlverhalten und nicht, wer einen bestimmten Satz geschrieben hat, und dafür war er nie gedacht. Lesen Sie ihn als Hinweis: Er sagt, wo ein Modell auf den Text reagiert hat, nicht, was während des Schreibens passiert ist.
Fragen, die sich lohnen, bevor Sie aufgrund eines Werts handeln:
- Ist der Text lang genug für eine aussagekräftige Lesart? Unter 150 Wörtern ist ein Wert schwache Evidenz.
- Welche Passagen wurden hervorgehoben, und wirken sie schablonenhaft, wenn Sie sie erneut lesen?
- Stimmt ein zweiter Detektor bei denselben Passagen zu?
- Gibt es Belege zum Schreibprozess, etwa Entwürfe, Notizen oder eine Versionshistorie?
- Würde dieses Ergebnis eine Entscheidung über eine Person verändern? Wenn ja, wer sollte es mit Ihnen deuten?
Sollte ZeroGPT als Beweis für KI-Urheberschaft gelten?
Nein. Ein Detektor-Ergebnis ist ein Beleg unter mehreren, und die oben genannten Studien dokumentieren beide Fehlerarten auf realen Datensätzen. Eine Einrichtung, die einen einzelnen Wert als Beweis behandelt, setzt sich falschen Beschuldigungen aus, und die PeerJ-Arbeit zeigt, dass diese Fehler nicht gleichmäßig verteilt sind: Nicht muttersprachlich englisch schreibende Personen trugen mehr davon, was die Folgen verschlimmert statt verringert.
Wo Urheberschaft zählt, ist der Schreibprozess der stärkere Beleg: Entwürfe, Versionshistorie, Notizen, Quellenangaben, die Fähigkeit der schreibenden Person, über die Arbeit zu sprechen, und die geltenden Regeln. Ein Detektor kann auf Passagen hinweisen, die ein Gespräch verdienen. Er kann nicht sagen, was passiert ist, und danach sollte man ihn nicht fragen.
Was tun, wenn ZeroGPT Ihren Text markiert
Wenn das Ergebnis wichtig ist, arbeiten Sie es in Ruhe durch, statt reflexhaft umzuschreiben. Die meisten markierten Passagen fallen in eine von zwei Gruppen: Schreiben, das wirklich Arbeit braucht, und Schreiben, das schlicht formal oder stilistisch vorhersagbar ist. Nur die erste Gruppe lohnt Bearbeitung, und die folgenden Schritte dienen dazu, sie zu unterscheiden.
- 1
Lesen
Lesen Sie die hervorgehobene Passage selbst und beurteilen Sie sie als Text.
- 2
Vergleichen
Lassen Sie denselben Text durch einen zweiten Detektor laufen und vergleichen Sie.
- 3
Untersuchen
Achten Sie auf wiederkehrende Satzformen, leere Übergänge und vage Aussagen.
- 4
Prüfen
Kontrollieren Sie Argument, Fakten und Quellenangaben getrennt voneinander.
- 5
Belege
Sammeln Sie Entwürfe und Versionshistorie, wenn die Urheberschaft infrage steht.
- 6
Überarbeiten
Schreiben Sie nur die Passagen um, die wirklich besser werden müssen.
Manchmal zeigt die Markierung auf eine echte Schwäche: Absätze, die auf einer einzigen Satzform gebaut sind, Übergänge, die nichts verbinden, Aussagen ohne ein Beispiel dahinter. Ist das der Fall, kann der Humanizer von AI-2-Human die wiederholende oder schablonenhafte Passage in eine natürlichere Fassung umschreiben und Ihre Kernbedeutung erhalten; anschließend bearbeiten Sie das Ergebnis mit Ihrer eigenen Stimme.
Sollten Sie ZeroGPT mit einem anderen KI-Detektor vergleichen?
Ja, besonders wenn das Ergebnis Folgen hat. Detektoren nutzen verschiedene Modelle, verschiedene Trainingsdaten und verschiedene Schwellen, eine Uneinigkeit zwischen zweien ist also normal und kein Beweis, dass eines defekt ist. Diese Seite ist ihr eigenes Beispiel: Dasselbe Werkzeug wurde je nach Datensatz sehr unterschiedlich bewertet, und verschiedene Werkzeuge ordneten sich innerhalb eines Datensatzes unterschiedlich ein.
Ein Vergleich hilft in beide Richtungen. Wenn zwei Detektoren dieselbe Passage hervorheben, verdient diese Passage ein genaues Lesen. Wenn sie deutlich auseinandergehen, sagt diese Abweichung, dass der Text nahe an einer Entscheidungsgrenze liegt und die Zahl weich ist, was man wissen sollte, bevor man etwas umschreibt oder jemand anderes aufgrund der Zahl handelt.
Der Detector von AI-2-Human meldet seine eigene Lesart des Textes und zeigt auf die Passagen, die noch generiert wirken, womit Sie zwei Deutungen nebeneinanderlegen können, bevor Sie entscheiden, was Sie ändern.
Vor der Abgabe: eine praktische Checkliste
- Ich behandle das ZeroGPT-Ergebnis als Signal und nicht als Beweis.
- Ich habe die Passagen gelesen, die Anlass zur Sorge gaben.
- Ich habe Länge und Art des geprüften Textes berücksichtigt.
- Ich habe das Ergebnis mit einem anderen Detektor verglichen, weil das Ergebnis wichtig ist.
- Ich habe geprüft, ob das Schreiben wirklich wiederholend oder schablonenhaft ist.
- Ich habe Entwürfe oder Versionshistorie aufbewahrt, wo die Urheberschaft infrage stehen könnte.
- Ich habe Fakten und Quellenangaben getrennt von der KI-Erkennung geprüft.
- Ich habe nur die Passagen überarbeitet, die tatsächlich besser werden mussten.
Häufige Fragen
ZeroGPT kann KI-generierten von menschlichem Text in manchen Datensätzen wirksam unterscheiden, aber die Genauigkeit ist nicht bei jeder Textart gleich. Unabhängige Studien haben in einem akademischen Test starke und in einem anderen deutlich schwächere Ergebnisse gemeldet. Falsch-positive und falsch-negative Ergebnisse sind beide möglich, deshalb ist das Resultat am besten als ein Signal zu behandeln und nicht als definitiver Beweis.
Es gibt keinen einzelnen Wert. In einer akademischen Studie mit 1.000 Texten, veröffentlicht in Acta Neurochirurgica, erreichte ZeroGPT 94,4 % Sensitivität und 93,2 % Spezifität bei der von den Forschenden gewählten Schwelle. In einer Studie in PeerJ Computer Science zu wissenschaftlichen Zusammenfassungen erreichte es 64,35 % Genauigkeit bei einer Falsch-Positiv-Rate von 16,67 % und einer Falsch-Negativ-Rate von 45,14 %. Beides sind reale Messungen auf verschiedenen Datensätzen, weshalb die eigene Angabe von über 98 % die internen Auswertungen beschreibt und kein allgemeines Ergebnis.
Ja. Beide Fehlerarten sind in unabhängiger Forschung dokumentiert: menschliches Schreiben als KI eingeordnet und KI-generiertes Schreiben als menschlich eingeordnet. Die Rate hängt vom Datensatz, vom Genre, vom erzeugenden Modell, von der Textlänge und von der verwendeten Schwelle ab, deshalb sollte kein einzelnes Ergebnis als endgültig gelten.
Ja. Eine kleine explorative Studie mit zehn authentischen studentischen Essays fand, dass ZeroGPT und ein zweiter Detektor fünf davon als KI-generiert und fünf als menschlich etikettierten, obwohl alle zehn von Studierenden stammten. Eine größere Studie zu wissenschaftlichen Zusammenfassungen maß eine Falsch-Positiv-Rate von 16,67 %, mit mehr Fehlern bei nicht muttersprachlich englisch schreibenden Personen und in bestimmten Disziplinen.
Formales, sehr poliertes oder wiederholendes Schreiben kann den Mustern ähneln, die ein Detektor mit Maschintext verbindet, und kurze Stichproben geben ihm wenig Material. Die Dokumentation von ZeroGPT sagt dasselbe und empfiehlt, konkrete Details, Quellen und einen abwechslungsreichen Satzrhythmus zu ergänzen. Ist eine Passage wirklich schablonenhaft, hilft Umschreiben; ist sie nur formal, sagt der Wert mehr über den Detektor als über das Schreiben.
Ja. Eine unabhängige Studie maß auf ihrem Datensatz wissenschaftlicher Zusammenfassungen eine Falsch-Negativ-Rate von 45,14 %, und die Leistung eines Detektors verändert sich auch mit dem erzeugenden Modell, mit den Anweisungen und damit, wie stark der Text danach bearbeitet wurde. Ein niedriger KI-Wert belegt nicht, dass ein Text von einer Person geschrieben wurde.
ZeroGPT gibt an, sich an mehrere Sprachmodellfamilien und nicht nur an ChatGPT zu richten, und die Studie in Acta Neurochirurgica fand für Ausgaben von GPT-3.5, GPT-4 und GPT-4o steigende KI-Wahrscheinlichkeitswerte. Das heißt nicht, dass jede ChatGPT-Passage markiert wird oder dass eine markierte Passage beweist, dass ChatGPT verwendet wurde.
In den beiden auf dieser Seite zitierten Datensätzen waren die gemeldeten Werte von GPTZero höher als die von ZeroGPT: 100 % gegenüber 94,4 % Sensitivität in der Acta-Neurochirurgica-Studie und 97,22 % gegenüber 64,35 % Genauigkeit in der PeerJ-Studie. Das ist ein Ergebnis über diese Tests und keine allgemeine Rangfolge: Datensätze, Schwellen und Produktversionen ändern sich, und beide Werkzeuge erzeugten weiterhin Fehler. Vergleichen Sie lieber an Ihrem eigenen Text, statt eine Reihenfolge anzunehmen.
Ja, und das tun sie oft. Verschiedene Modelle, Trainingsdaten und Entscheidungsschwellen bedeuten, dass dieselbe Passage von zwei Werkzeugen unterschiedlich gelesen werden kann. Die Studie in Advances in Simulation verglich drei Detektoren über fünf Bedingungen der KI-Nutzung und fand, dass die Werte sich mit der Bedingung bewegten und die Werkzeuge nicht übereinstimmten.
Nicht als einzigen Beleg. Die dokumentierten Falsch-Positiv-Raten und der Befund, dass Fehler ungleichmäßig auf nicht muttersprachlich englisch schreibende Personen entfallen, sprechen dafür, ein Detektor-Ergebnis als Ausgangspunkt eines Gesprächs über die Arbeit zu behandeln. Entwürfe, Versionshistorie, Notizen und die Fähigkeit der lernenden Person, über das Material zu sprechen, wiegen mehr als jeder einzelne Wert.
Lesen Sie die hervorgehobenen Passagen selbst, vergleichen Sie das Ergebnis mit einem anderen Detektor, untersuchen Sie den Text auf wiederkehrende Satzformen und leere Übergänge, prüfen Sie Ihre Fakten und Quellenangaben und bewahren Sie Ihre Entwürfe auf. Überarbeiten Sie die Passagen, die tatsächlich schablonenhaft klingen, statt einen bereits klaren Text umzuschreiben. AI-2-Human kann den Überarbeitungsdurchgang übernehmen und ein zweites Erkennungssignal liefern.
Ja, wenn das Ergebnis wichtig ist. Eine zweite Lesart sagt Ihnen, ob ein Resultat über Werkzeuge hinweg stabil ist oder davon abhängt, welches Sie zufällig benutzt haben. Wo beide Detektoren dieselbe Passage hervorheben, lohnt diese Passage eine Prüfung; wo sie deutlich auseinandergehen, ist der Wert weich und sollte allein nichts entscheiden.
Mit dem AI Detector prüfen →Ja. Der Detector von AI-2-Human liefert ein weiteres Erkennungssignal zum selben Text und zeigt die Passagen, die generiert wirken, sodass Sie zwei Deutungen vergleichen können, bevor Sie entscheiden, was Sie ändern. Er meldet seine eigene Lesart und keine Kopie des ZeroGPT-Modells.
AI Detector ausführen →Ein Umschreibungs-Tool verändert den Text, und ein anderer Text kann anders bewertet werden, aber niemand kann eine bestimmte Zahl zusagen: Detektoren und Schwellen ändern sich ständig. Deshalb ist der nützliche Ansatz, Schreiben zu verbessern, das es wirklich nötig hat, und dann erneut zu prüfen und zu vergleichen. AI-2-Human schreibt wiederholende, schablonenhafte Passagen in eine natürlichere Fassung um und behält Ihre Bedeutung.
KI-Text humanisieren →Quellen und redaktionelle Hinweise
- ZeroGPT: KI-Detektor (auf Englisch)
- ZeroGPT: häufig gestellte Fragen (auf Englisch)
- Acta Neurochirurgica: Genauigkeit und Grenzen von KI-Erkennungstools (auf Englisch)
- PeerJ Computer Science: Kompromisse zwischen Genauigkeit und Verzerrung bei der KI-Text-Erkennung (auf Englisch)
- Advances in Simulation: verschiedene Formen KI-generierter Inhalte erkennen (auf Englisch)
- ASEAN Journal of Open and Distance Learning: falsch-positive Ergebnisse bei der KI-Schreib-Erkennung (auf Englisch)
AI-2-Human ist weder mit ZeroGPT verbunden noch von ZeroGPT unterstützt. Die Produktinformationen von ZeroGPT und die zitierte Forschung wurden am 20. September 2026 eingesehen. Detektorverhalten und Produktfunktionen können sich mit der Zeit ändern.
Aktualisiert